算法设计与分析
绪论
计算机学院 张腾
tengzhang@hust.edu.cn
课程概况
授课:张腾 tengzhang@hust.edu.cn
时间:第 9 ~ 16 周,周一 3 ~ 4 节课、周三 3 ~ 4 节,共 32 学时
地点:西十二楼 S401
主页:https://avanti1980.github.io/course-alg/
考核:闭卷考试 (70%)、作业 + 考勤 (30%)
参考书目
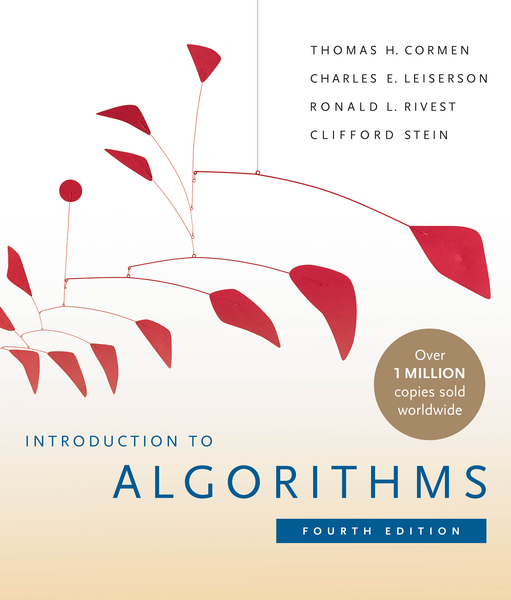
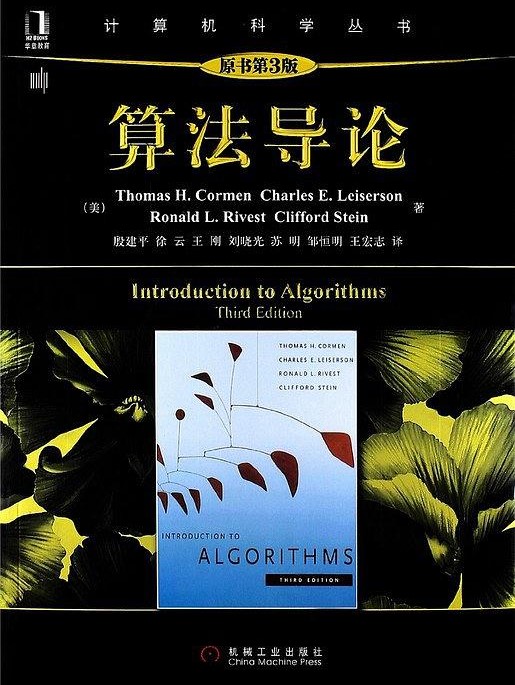
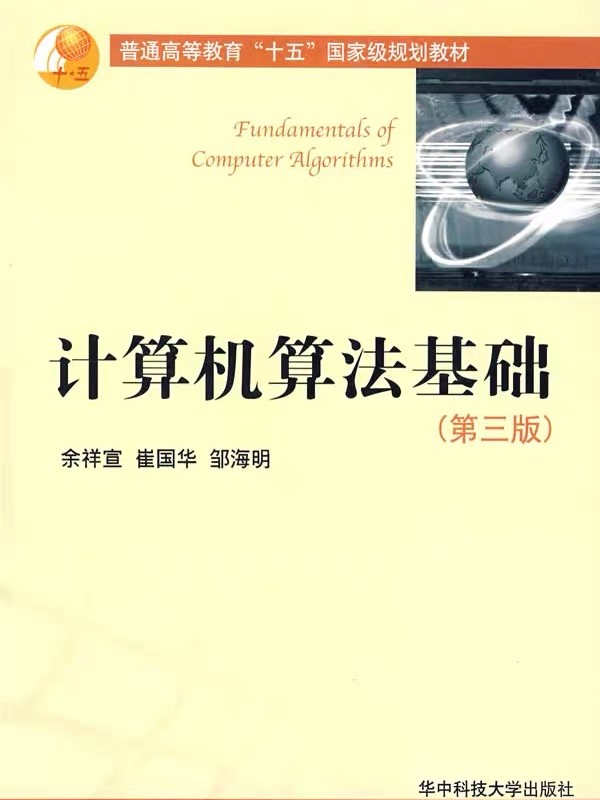
Introduction to Algorithms 第三版共 1292 页,第四版共 1312 页
本讲目标
回答三个问题
是什么 what
为什么 why
怎么样 how
最早的算法
两河流域 古巴比伦 汉谟拉比王朝 (公元前1800年 — 公元前1600年)
泥板上的楔形文字
一个蓄水池
深度为 3.33,挖出土的体积为 27.78
长度比宽度多 0.83
应当取深度 3.33 的倒数,得 0.3
乘以体积 27.78,得 8.33
取 0.83 的一半,再取平方,得 0.17
加 8.33,得 8.51
取平方根得 2.92
将这个数字复制得到两个,其中一个加上 0.42,另一个减去 0.42
可以算出 3.33 是长度,2.5 是宽度
两点说明
算法不是计算机才能做的事,计算机出现前,算法就已经存在很久了
算法的朴素本质:完成任务所需的明确步骤序列
大象装冰箱算法
- 把冰箱门打开
- 把大象装进去
- 把冰箱门带上
上课算法
- 锁门离开宿舍
- 骑车到西十二
- 走到上课教室
- 寻找位置坐下
另一个例子
YBC 7289 号泥板:求 2 的平方根算法
对 2 的平方根提出一个猜测数
按如下方式重复生成新的猜测数:
用 2 除以当前猜测数
所得数字加上猜测数
除以 2 得到一个新的猜测数
当最新的两个猜测数几乎相等时,停止重复
该算法中已经出现了选择和循环
算法和计算机
算法是我们设计的一组明确的步骤序列
程序设计是用计算机能理解的编程语言实现这些步骤的活动
计算机算法:运行在计算机上,把输入转换成输出的一组计算步骤
- 步骤必须在有限步内结束
- 步骤必须明确,无二义性
- 三种控制结构:顺序、选择、循环
- 输入输出由待求解的问题决定
计算机算法
已全面接管生活
Algorithm 一词的由来
“算法之父” —— 阿尔·花拉子米 (约 780 — 850 年)
9 世纪波斯数学家、天文学家、地理学家
- 穆罕默德·伊本·穆萨·阿尔·花拉子米
- Muḥammad ibn Mūsā al-Khwārizmī
- محمد بن موسى الخوارزمي
花拉子米早年游学印度,约于公元 825 年写成两部划时代著作
1. The Compendious Book on Calculation by Completion and Balancing
- 第一本解决一次方程及一元二次方程的系统性著作
- 代数 (algebra) 一词从本书的阿拉伯语标题 al-jabr 派生而来,意为恢复平衡
Algorithm 一词的由来
花拉子米早年游学印度,约于公元 825 年写成两部划时代著作
2. On the Calculation with Hindu Numerals
- 印度数字算术,介绍了十进制数字系统
- 意大利数学家斐波那契前往阿拉伯地区学习,将花拉子米的名字和十进制数字算术都翻译成拉丁语 Algorismus,引入欧洲
- 欧洲人误以为十进制数字为阿拉伯人发明,称为阿拉伯数字
词汇演化
- 拉丁语算术 Algorismus => 英语算术 Algorism [ˈælɡəˌrɪzəm]
- 英语算术 Algorism 后来逐渐被 Arithmetic [əˈrɪθmətɪk] 替代
- Algorism 的异体词 Algorithm [ˈælɡərɪðəm] => 计算机专业术语“算法”
Algorithm 一词的由来
花拉子米:来自花拉子模的人
Algorithm 一词的由来
1219 年,蒙古西征灭了花拉子模,但花拉子米的学术遗产已超越时空
丘处机:城中常十余万户,国破以来,存者四之一
耶律楚材:寂莫河中府,声名昔日闻,城隍连畎亩,市井半邱坟
《射雕英雄传》第三十七回 从天而降
原来蒙古大军分路进军,节节获胜,再西进数百里,即是花拉子模的名城撒麻尔罕。成吉思汗哨探获悉,此城是花拉子模的新都,结集重兵十余万守御,城精粮足……
成吉思汗自进军花拉子模以来,从无如此大败,当晚在帐中悲痛爱孙之亡,怒如雷霆。郭靖回帐翻阅《武穆遗书》,要想学一个攻城之法,但那撒麻尔罕的城防与中国大异,遗书所载的战法均无用处……
郭靖正欲说出辞婚之事,忽听得远处传来……,只道城中投降了的花拉子模军民突然起事,……。成吉思汗笑道:“没事,没事。这狗城不服天威,累得我损兵折将,又害死了我爱孙,须得大大洗屠一番。大家都去瞧瞧。”
本讲目标
回答三个问题
是什么 what
为什么 why
怎么样 how
量水问题
两个无刻度水桶,总容量分别为 9 升和 6 升,如何量出 3 升的水?
量水问题
两个无刻度水桶,总容量分别为 9 升和 6 升,如何量出 3 升的水?
算法:
将 9 升的桶装满水
向 6 升的桶倒水,直到满
9 升桶中剩下的即为 3 升
如果总容量分别为 7 升和 5 升,如何量出 1 升的水?
量水问题
两个无刻度水桶,总容量分别为 7 升和 5 升,如何量出 1 升的水?
算法:
将 5 升的桶装满水,5/5、0/7
将 5 升的桶中的 5 升水全部倒入7升的桶中,0/5、5/7
将 5 升的桶装满水,5/5、5/7
向 7 升的桶倒水,直到满,此时 5 升的桶中还剩 3 升水,3/5、7/7
将 7 升的桶中的水倒掉,3/5、0/7
将 5 升的桶中的 3 升水倒入 7 升的桶中,0/5、3/7
将 5 升的桶装满水,5/5、3/7
向 7 升的桶倒水,直到满,此时 5 升的桶中还剩 1 升水,1/5、7/7
量水问题 一般化
两个无刻度水桶,总容量分别为$a$升和$b$升
- 是否可以量出$t$升的水?
- 如果可以,请给出具体方案,其中$a$、$b$、$t$都是正整数
思路:装满对应$+a$或$+b$,倒掉对应$-a$或$-b$
能否通过若干次$\pm a$、$\pm b$得到$t$?即存在整数$x$、$y$使得$ax + by = t$?
前面的例子:$5 \cdot 3 - 7 \cdot 2 = 1$
由裴蜀定理,$t$必须是$a$、$b$最大公约数的倍数,若$t=1$,则$a$、$b$互素
量水问题 一般化
原问题:是否存在整数$x$、$y$使得$ax + by = t$?
问题 1:求最大公约数 (greatest common divisor, gcd)
输入正整数$a$、$b$,输出$d = \gcd(a,b)$
令$a \gets a / d$、$b \gets b/ d$、$t \gets t / d$,此时问题不变但$\gcd(a,b) = 1$
问题 2:求整数$x$、$y$
输入互素的正整数$a$、$b$,输出整数$x$、$y$使得$ax+by=1$
$x \cdot t$、$y \cdot t$就是原问题的解
暴力穷举法
最朴素的思路:一个个试
从$1$遍历到$\min(a,b)$,最大能同时整除$a$、$b$的数就是最大公约数
def gcd(a, b):
    for i in range(1, min(a, b) + 1):        # 最大公约数不会大于两者中的较小者
        if ((a % i == 0) and (b % i == 0)):  # 同时整除即为公约数
            gcd = i
    return gcd
对$x$从$1$遍历到$b$,检测$y$是否可同时为整数
def coef(a, b):
    for x in range(1, b):         # 0 a 2a ... (b-1)a构成一个模b的剩余系
        if (1 - a * x) % b == 0:  # 若y也为整数
            y = int((1 - a * x) / b)
            return x, y
欧几里得 辗转相除法
记$a / b = q \cdots r$且$r < b$,于是$\gcd(a,b) \mid r$
$\gcd(a,b) = \gcd(b,r)$,不断令$(a,b) = (b,r)$直到$r = 0$即能整除
def Euclidean(a, b):  # 辗转相除
    while a % b:
        a, b = b, a % b
    return b


def Euclidean_coef(a, b):  # 辗转相除
    if a % b == 0:         # 递归停止条件:若b可以整除a
        return b, 1, 1 - int(a / b)
    else:
        d, x, y = Euclidean_coef(b, a % b)
        return d, y, x - int(a / b) * y
- 暴力穷举法循环轮数为$\min(a, b)$,每轮做$2$次取模运算
- 辗转相除法循环轮数约为$\log(\max(a,b))$,每轮做$1$次取模运算
九章算术 更相减损术
$\gcd(a,b) = \gcd(a-b,b)$,不断令$(a,b) = (a-b,b)$直到$a=b$
def gxjs(a, b):  # 更相减损
    while True:
        if a > b:
            a = a - b
        elif a < b:
            b = b - a
        else:
            return b


def gxjs_coef(a, b):  # 更相减损
    if a == b:        # 递归停止条件:a = b
        return b, 1, 0
    elif a > b:
        d, x, y = gxjs_coef(a - b, b)
        return d, x, y - x
    else:
        d, x, y = gxjs_coef(a, b - a)
        return d, x - y, y
- 避免了低效的取模运算,只做加减法
- 最坏情况下循环轮数为$\max(a, b)$,例如$\gcd(10000,1)$
改进的更相减损术
更相减损结合移位除法 — 古代中国智慧与现代计算机的结合
对$a$、$b$分奇偶性讨论
def gxjs2(a, b):  # 改进的更相减损
    if a == b:
        return a
    while True:
        if not (a & 1) and not (b & 1):  # 均为偶 gcd(a,b) = 2 * gcd(a/2, b/2)
            return gxjs2(a >> 1, b >> 1) << 1
        elif not (a & 1) and (b & 1):    # a偶 b奇 gcd(a,b) = gcd(a/2, b)
            return gxjs2(a >> 1, b)
        elif (a & 1) and not (b & 1):    # a奇 b偶 gcd(a,b) = gcd(a, b/2)
            return gxjs2(a, b >> 1)
        else:                            # 均为奇 更相减损 gcd(a,b) = gcd(a-b, b)
            if a > b:
                return gxjs2(a - b, b)
            else:
                return gxjs2(a, b - a)
循环轮数约为$\log(\max(a, b))$,同辗转相除,但避免了取模运算
求最大公约数
四种方法
| 方法 | 循环轮数 | 每轮操作 |
|---|---|---|
| 暴力穷举法 | $\min(a, b)$ | $2$次取模运算 |
| 辗转相除法 | 约$\log(\max(a,b))$ | $1$次取模运算 |
| 更相减损术 | 最坏$\max(a, b)$ | 无取模运算 |
| 改进的更相减损术 | 约$\log(\max(a,b))$ | 无取模运算 |
- 设计正确的算法:对每个输入,都能给出正确的输出
- 分析算法的效率:比较时间与空间开销,从多种方案中选出最优
排序
输入:数组$a = \langle a_1, a_2, \ldots, a_n \rangle$
输出:$a$的元素的重排列$\langle a'_1, a'_2, \ldots, a'_n \rangle$且$a'_1 \le a'_2 \le \cdots \le a'_n$
- 新华字典按音序排序
- 银行流水按时间排序
- 搜索引擎的结果按与搜索关键字的相关性排序
- 服务于其他算法,如作为二分搜索的前序步骤
借助排序这个基本问题,我们将学习:
- 如何证明算法的正确性
- 如何分析算法的效率
五种基于比较的排序算法:冒泡、选择、插入、归并、快速排序
冒泡排序
相邻元素不断比较和交换,让较小的元素逐步“冒泡”到数组前端
冒泡排序 正确性
def bubble_sort(a, n):
    for i in range(n - 1):
        for j in range(n - 1, i, -1):
            if a[j] < a[j - 1]:
                a[j], a[j - 1] = a[j - 1], a[j]
如何证明算法的正确性?
循环不变式 (loop-invariant):一个关于循环状态的命题,满足:
- 初始:在初次进入循环前成立
- 保持:若每次进入循环前成立,则下次进入循环前还成立
- 终止:循环可以终止,此时循环不变式提供一个有用的性质
内层:每次进入循环前,子数组$a[j, \ldots, n-1]$的第一个元素最小
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素
冒泡排序 正确性
def bubble_sort(a, n):
    for i in range(n - 1):
        for j in range(n - 1, i, -1):
            if a[j] < a[j - 1]:
                a[j], a[j - 1] = a[j - 1], a[j]
内层:每次进入循环前,子数组$a[j, \ldots, n-1]$的第一个元素最小
- 初始:$j = n-1$,子数组$a[n-1]$只有一个元素,循环不变式显然成立
- 保持:若$a[j]$是$a[j, \ldots, n-1]$中最小的,循环中比较$a[j-1]$和$a[j]$并将小者置于前,则再次进入循环前$a[j-1, \ldots, n-1]$的第一个元素最小
- 终止:$j = i$,此时子数组$a[i, \ldots, n-1]$第一个元素最小
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素
冒泡排序 正确性
def bubble_sort(a, n):
    for i in range(n - 1):
        for j in range(n - 1, i, -1):
            if a[j] < a[j - 1]:
                a[j], a[j - 1] = a[j - 1], a[j]
内层:每次进入循环前,子数组$a[j, \ldots, n-1]$的第一个元素最小
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素
- 初始:$i=0$,子数组$a[0, \ldots, -1]$为空,循环不变式显然成立
- 保持:若子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素,又内层循环终止时$a[i, \ldots, n-1]$的第一个元素最小,因此子数组$a[0, \ldots, i]$亦有序排列着整个数组最小的$i+1$个元素
- 终止:$i = n-1$,此时子数组$a[0, \ldots, n-2]$有序排列着整个数组最小的$n-1$个元素,故剩余的$a[n-1]$是最大元素,从而整个数组已排好序
冒泡排序 时间分析
| bubble_sort(a, n): | 时间 | 次数 |
|---|---|---|
| for i in range(n-1): | $c_1, c'_1$ | 对$i$赋值$1$次、自增$n-1$次 |
| $c''_1$ | $i$与$n-1$比较$n$次 | |
| for j in range(n-1, i, -1): | $c_2, c'_2$ | 对$j$赋值$n-1$次、自减$\frac{n^2-n}{2}$次 |
| $c''_2$ | $j$与$i$比较$\frac{n^2+n-2}{2}$次 | |
| if a[j] < a[j-1]: | $c_3$ | 比较$\frac{n^2-n}{2}$次 |
| a[j], a[j-1] = a[j-1], a[j] | $c_4$ | 交换$\sum_{i=0}^{n-2} t_i$次 |
\begin{align} T = c_1 & + c'_1 (n-1) + c''_1 n + c_2 (n-1) + c'_2 \frac{n^2-n}{2} + c''_2 \frac{n^2+n-2}{2} \\ & + c_3 \frac{n^2-n}{2} + c_4 \sum_{i=0}^{n-2} t_i = a n^2 + b n + c + c_4 \sum_{i=0}^{n-2} t_i \end{align}
- $t_i$是外层循环第$i$轮中内层循环$a[j]$和$a[j-1]$交换的次数
- $a,b,c$是关于各个操作执行时间的常数
冒泡排序 时间分析
\begin{align} T = a n^2 + b n + c + c_4 \sum_{i=0}^{n-2} t_i \end{align}
$t_i$是外层循环第$i$轮中内层循环$a[j]$和$a[j-1]$交换的次数
- 最好情况下 (初始顺序) 发生$0$次
- 最坏情况下 (初始逆序) 发生$n-1-i$次
\begin{align} a n^2 + b n + c & \le T \le a n^2 + b n + c + c_4 \sum_{i=0}^{n-2} (n-1-i) \end{align}
综上,冒泡排序的时间复杂度为$\Theta(n^2)$
- 二次函数的系数与具体执行算法的计算机相关,可以忽略
- 我们仅关注问题规模达到一定程度时的时间复杂度,当$n$足够大时,二次函数中的一次项、常数项可以忽略
$\Theta$是渐进符号,其严格定义我们将在第二讲“函数的增长”中学习
冒泡排序 小结
def bubble_sort(a, n):
    for i in range(n - 1):
        for j in range(n - 1, i, -1):
            if a[j] < a[j - 1]:
                a[j], a[j - 1] = a[j - 1], a[j]
\begin{align} a n^2 + b n + c & \le T \le a n^2 + b n + c + c_4 \sum_{i=0}^{n-2} (n-1-i) \end{align}
| 算法 | 最坏情况下运行时间 | 最好情况下运行时间 | 最坏情况下交换次数 |
|---|---|---|---|
| 冒泡排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ |
选择排序
最小元与第一个元素互换,次小元与第二个元素互换,……
def selection_sort(a, n):
    for i in range(n - 1):
        smallest = i
        for j in range(i + 1, n):
            if a[j] < a[smallest]:
                smallest = j
        a[i], a[smallest] = a[smallest], a[i]
选择排序 正确性
def selection_sort(a, n):
    for i in range(n - 1):
        smallest = i
        for j in range(i + 1, n):
            if a[j] < a[smallest]:
                smallest = j
        a[i], a[smallest] = a[smallest], a[i]
内层:每次进入循环前,$a[smallest]$是子数组$a[i, \ldots, j-1]$的最小元素
- 初始:$j=i+1$,子数组$a[i, \ldots, j-1]$只有$a[smallest]$,循环不变式成立
- 保持:若$a[smallest]$是子数组$a[i, \ldots, j-1]$的最小元素,经过第 5 ~ 6 行比较后,$a[smallest]$将是子数组$a[i, \ldots, j]$的最小元素
- 终止:$j = n$,$a[smallest]$是$a[i, \ldots, n-1]$的最小元素
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素
选择排序 正确性
def selection_sort(a, n):
    for i in range(n - 1):
        smallest = i
        for j in range(i + 1, n):
            if a[j] < a[smallest]:
                smallest = j
        a[i], a[smallest] = a[smallest], a[i]
内层:每次进入循环前,$a[smallest]$是子数组$a[i, \ldots, j-1]$的最小元素
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素
- 初始:同冒泡排序
- 保持:若子数组$a[0, \ldots, i-1]$有序排列着整个数组最小的$i$个元素,又$a[smallest]$是子数组$a[i, \ldots, n-1]$的最小元素,经过第 7 行的交换,$a[i]$是$a[i, \ldots, n-1]$的最小元素,因此子数组$a[0, \ldots, i]$有序排列着整个数组最小的$i+1$个元素
- 终止:同冒泡排序
选择排序 时间分析
def selection_sort(a, n):
    for i in range(n - 1):
        smallest = i
        for j in range(i + 1, n):
            if a[j] < a[smallest]:
                smallest = j
        a[i], a[smallest] = a[smallest], a[i]
- 第 5 行的比较操作在二重循环里,因此算法总时间$\in \Theta(n^2)$
- 第 7 行的交换操作在一重循环里,因此最坏情况下交换次数$\in \Theta(n)$
| 算法 | 最坏情况下运行时间 | 最好情况下运行时间 | 最坏情况下交换次数 |
|---|---|---|---|
| 冒泡排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ |
| 选择排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n)$ |
插入排序
类似打牌时摸牌理牌的过程,手上始终是理好序的牌,每摸一张新牌,将其插入适当的位置,保持牌序不被破坏
插入排序 正确性
def insertion_sort(a, n):
    for i in range(1, n):
        key = a[i]
        j = i - 1
        while j >= 0 and key < a[j]:
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key
内层:每次进入循环前,$key \le a[j+1]$
- 初始:$key = a[i] = a[j+1]$
- 保持:内层循环的进入条件之一是$key < a[j]$,进入后$j$自减$1$变成$j'$,那么下次进入循环前显然有$key < a[j] = a[j'+1]$
- 终止:循环条件不被满足,要么$j=-1$即$key < a[0]$,要么$key > a[j]$
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$已经排好序
插入排序 正确性
def insertion_sort(a, n):
    for i in range(1, n):
        key = a[i]
        j = i - 1
        while j >= 0 and key < a[j]:
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key
内层:每次进入循环前,$key \le a[j+1]$
外层:每次进入循环前,子数组$a[0, \ldots, i-1]$已经排好序
- 初始:子数组$a[0]$只有一个元素,已经排好序
- 保持:内层循环终止时,要么$key < a[0]$,故令$a[0] = key$;要么$key > a[j]$ (注意同时有$key \le a[j+1]$),故令$a[j+1] = key$,无论哪种情况都为$a[i]$在已经排好序的子数组$a[0, \ldots, i-1]$中找到了正确的插入位置,故下次进入循环前$a[0, \ldots, i]$已经排好序
- 终止:$i = n$,$a[0, \ldots, n-1]$已经排好序
插入排序 时间分析
| insertion_sort(a, n): | 时间 | 次数 |
|---|---|---|
| for i in range(1, n): | $c_1, c'_1$ | 对$i$赋值$1$次、自增$n-1$次 |
| $c''_1$ | $i$与$n$比较$n$次 | |
| key = a[i] | $c_2$ | 对$key$赋值$n-1$次 |
| j = i - 1 | $c_3$ | 对$j$赋值$n-1$次 |
| while j >= 0 and key < a[j]: | $c_4,c'_4$ | 比较$2 \sum_{i=1}^{n-1} t_i + \{1,2\}$次 |
| a[j+1] = a[j] | $c_5$ | 赋值$\sum_{i=1}^{n-1} t_i$次 |
| j -= 1 | $c_6$ | 对$j$赋值$\sum_{i=1}^{n-1} t_i$次 |
| a[j+1] = key | $c_7$ | 赋值$n-1$次 |
\begin{align} T = b n + c + d \sum_{i=1}^{n-1} t_i \end{align}
其中$t_i$是外层 for 循环第$i$轮中内层 while 循环的执行次数
插入排序 时间分析
$t_i$是外层 for 循环第$i$轮中内层 while 循环的执行次数
- 最好情况下 (初始顺序) 执行$0$次
- 最坏情况下 (初始逆序) 执行$i$次
\begin{align} b n + c \le b n + c + d \sum_{i=1}^{n-1} t_i \le b n + c + d \cdot \frac{n^2-n}{2} \end{align}
| 算法 | 最坏情况下运行时间 | 最好情况下运行时间 | 最坏情况下交换次数 |
|---|---|---|---|
| 冒泡排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ |
| 选择排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n)$ |
| 插入排序 | $\Theta(n^2)$ | $\Theta(n)$ | $\Theta(n^2)$ |
插入排序无需在算法启动前就准备好完整的待排序数组,而是能够边接收数据、边进行排序处理,具备这一特性的算法称为在线算法 (online algorithm),该类算法天然适用于数据源动态、流式到达的应用场景;相比之下,冒泡、选择排序等必须预先获取完整输入数据的算法称为离线算法 (offline algorithm)
归并排序
分治:将原问题分成若干同类型、规模更小的子问题递归求解
- 分:将$a[low, \ldots, high]$分成$a[low, \ldots, mid]$、$a[mid+1, \ldots, high]$两部分,为使子问题规模相同,$mid$为$(low + high)/2$取整
- 治:分别对$a[low, \ldots, mid]$和$a[mid+1, \ldots, high]$进行排序,递归实现
- 合:将排好序的$a[low, \ldots, mid]$、$a[mid+1, \ldots, high]$合并成$a[low, \ldots, high]$
def merge_sort(a, low, high):
    if low < high:
        mid = int((low + high) / 2)  # 中间点
        merge_sort(a, low, mid)
        merge_sort(a, mid + 1, high)
        merge(a, low, mid, high)
- 分:第 3 行计算分解的中间点
- 治:第 4 ~ 5 行对子数组递归调用归并排序
- 合:第 6 行合并已排好序的两个子数组
归并排序的历史和计算机一样悠久,由计算机之父冯·诺依曼于 1945 年提出
归并排序
def merge_sort(a, low, high):
    if low < high:
        mid = int((low + high) / 2)  # 中间点
        merge_sort(a, low, mid)
        merge_sort(a, mid + 1, high)
        merge(a, low, mid, high)
归并排序
合:取两个子数组的最小元素做比较,并将小者取出
def merge(a, low, mid, high):

    # 子数组的长度
    n1, n2 = mid - low + 1, high - mid

    # 创建临时数组
    L, R = [0] * n1, [0] * n2

    # 拷贝数据到临时数组L
    for i in range(n1):
        L[i] = a[low + i]

    # 拷贝数据到临时数组R
    for j in range(n2):
        R[j] = a[mid + 1 + j]

    i, j, k = 0, 0, low

    # 归并L和R到a[low,...,high]
    while i < n1 and j < n2:
        if L[i] <= R[j]:
            a[k] = L[i]
            i += 1
        else:
            a[k] = R[j]
            j += 1
        k += 1

    # 拷贝L的剩余元素
    while i < n1:
        a[k] = L[i]
        i += 1
        k += 1

    # 拷贝R的剩余元素
    while j < n2:
        a[k] = R[j]
        j += 1
        k += 1
归并排序 时间分析
设将两个长度为$n/2$的有序数组合并的时间为$f(n)$
- 最好情况:其中一个的最大元素小于另一个的最小元素,$f(n) = n/2$
- 最坏情况:一直要比到两个数组的最大元素,$f(n) = n-1$
设长度为$n$的数组的排序时间为$T(n)$,则有递推关系
\begin{align} T(n) = \begin{cases} 1, & n = 1 \\ 2 \cdot T (n/2) + f(n), & n > 1 \end{cases} \end{align}
为求$T(n)$,假设
- $n = 2^t$,其中$t$为某个正整数,这样等号右边的$n/2$总是除得尽
- $f(n) = c \cdot n$,其中$c$为某个正常数
\begin{align} T(2^t) = \begin{cases} 1, & t = 0 \\ 2 \cdot T (2^{t-1}) + c \cdot 2^t, & t > 0 \end{cases} \end{align}
归并排序 时间分析
\begin{align} \begin{array}{lrclcl} (\spadesuit) & T(2^t) & = & 2 \cdot T (2^{t-1}) & + & c \cdot 2^t \\ (\heartsuit) & T(2^{t-1}) & = & 2 \cdot T (2^{t-2}) & + & c \cdot 2^{(t-1)} \\ & & \vdots & \\ (\clubsuit) & T(2^1) & = & 2 \cdot T (2^0) & + & c \cdot 2^1 \end{array} \end{align}
令$(\spadesuit) + (\heartsuit) \cdot 2 + \cdots + (\clubsuit) \cdot 2^{t-1}$,代入$n = 2^t$、$t = \lg n$、$T(2^0) = 1$可得
\begin{align} T(n) = T(2^t) = 2^t \cdot T(2^0) + c \cdot t \cdot 2^t = n + c \cdot \lg n \cdot n = \Theta (n \lg n) \end{align}
| 算法 | 最坏情况下运行时间 | 最好情况下运行时间 | 最坏情况下交换次数 |
|---|---|---|---|
| 冒泡排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ |
| 选择排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n)$ |
| 插入排序 | $\Theta(n^2)$ | $\Theta(n)$ | $\Theta(n^2)$ |
| 归并排序 | $\Theta(n \lg n)$ | $\Theta(n \lg n)$ | $\Theta(n \lg n)$ |
快速排序
分治:将原问题分成若干同类型、规模更小的子问题递归求解
- 分:将最后一个元素作为主元 (pivot),确定其在排好序的数组中的正确位置$m$,将小于、大于主元的元素分别挪到主元的左边、右边
- 治:分别对子数组$a[low, \ldots, m-1]$和$a[m+1, \ldots, high]$进行递归排序
- 合:什么也不做
def quick_sort(a, low, high):
    if low < high:
        m = partition(a, low, high)
        quick_sort(a, low, m - 1)
        quick_sort(a, m + 1, high)
- 分:第 3 行计算主元的正确位置,并将其它元素相应挪到主元的左右
- 治:第 4 ~ 5 行对子数组递归调用快速排序
快速排序由英国计算机学家 Tony Hoare (1980 年图灵奖得主) 于 1959 年提出,迄今依然是最流行的排序算法
快速排序
def quick_sort(a, low, high):
    if low < high:
        m = partition(a, low, high)
        quick_sort(a, low, m - 1)
        quick_sort(a, m + 1, high)
快速排序
def partition(a, low, high):

    # 最右元素作为主元
    pivot = a[high]

    # 小于主元的元素的存放位置 初始为最左
    i = low

    # low -> high-1 遍历其它元素
    for j in range(low, high):
        if a[j] <= pivot:
            # 小于主元的元素放到主元左边
            a[i], a[j] = a[j], a[i]
            i += 1  # 存放位置右移一位

    # 所有小于主元的元素已位于主元左边
    # 当前的i就是主元应该放的位置
    # 当前的a[i]大于主元
    a[i], a[high] = a[high], a[i]

    return i
快速排序 时间分析
确定主元正确位置、移动其它元素到主元的左右所需时间为$\Theta(n)$
设长度为$n$的数组的排序时间为$T(n)$,则有递推关系
\begin{align} T(n) = \begin{cases} 1, & n = 1 \\ T(n) = T(k) + T(n-1-k) + c \cdot n, & n > 1 \end{cases} \end{align}
- 最好情况:主元是中位数,$T(n) = 2 \cdot T (n/2) + c \cdot n$,同归并排序
- 最坏情况:主元是最大或最小元素,只产生一个规模为$n-1$的子问题,此时递推关系为$T(n) = T (n-1) + c \cdot n$,易知有$T(n) = \Theta(n^2)$
如何改进?
- 随机选取主元:简单有效,大概率避免最坏情况
- 三数取中法:随机取三个元素的中位数作为主元
- 混合策略:子问题规模较小时切换为插入排序 (实际库函数的常用技巧)
归并排序 vs. 快速排序
归并排序在最坏情况下仍能保证$\Theta(n \lg n)$,理论上最优;快速排序在实际工程实践中更受青睐:
- 归并排序在合并两个有序子数组时需开辟等大的辅助数组,递归过程中频繁的内存分配与释放会带来显著的性能开销
- 快速排序的期望时间复杂度也为$\Theta(n \lg n)$,即主元选取不当导致的时间复杂度退化是小概率事件;快速排序是原址排序 (in-place sort),仅需对连续内存区间内的元素进行就地交换,在 CPU 缓存命中率和空间效率上均更优
| 算法 | 最坏情况下运行时间 | 最好情况下运行时间 | 最坏情况下交换次数 |
|---|---|---|---|
| 冒泡排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ |
| 选择排序 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n)$ |
| 插入排序 | $\Theta(n^2)$ | $\Theta(n)$ | $\Theta(n^2)$ |
| 归并排序 | $\Theta(n \lg n)$ | $\Theta(n \lg n)$ | $\Theta(n \lg n)$ |
| 快速排序 | $\Theta(n^2)$ | $\Theta(n \lg n)$ | $\Theta(n^2)$ |
排序 小结
$\Theta(n \lg n)$和$\Theta(n^2)$的差别有多大?
| CPU | 算法 | 时间复杂度 | |
|---|---|---|---|
| 计算机 A | $10^{10}$条指令/秒 | 插入排序 | $2 \cdot n^2$ |
| 计算机 B | $10^7$条指令/秒 | 归并排序 | $50 \cdot n \lg n$ |
- 插入排序时间复杂度中的常数因子仅为归并排序的$2/50 = 1/25$
- 插入排序所在的计算机 A 的硬件比归并排序的快$10^{10} / 10^7 = 1000$倍
对长度一千万的数组进行排序,$n = 10^7$
\begin{align} \frac{2 \cdot (10^7)^2 \class{base01}{\text{指令}}}{10^{10} \class{base01}{\text{指令/秒}}} > 5.5 \class{base01}{\text{小时}}, \quad \frac{50 \cdot 10^7 \lg 10^7 \class{base01}{\text{指令}}}{10^7 \class{base01}{\text{指令/秒}}} < 20 \class{base01}{\text{分钟}} \end{align}
为什么研究算法
算法是计算技术的核心:它不仅决定程序快慢,更决定问题能否求解
- 升级硬件可以提速,但提升往往有物理上限
- 选择更优的算法,带来的提升可以是数量级的,甚至是决定性的
如果计算资源无限,还需要研究算法吗?
- 硬件再快也终归有限;而大数据时代,问题规模的增长远超硬件进步
- 好的算法让我们能解决更大、更难的问题
- 算法素养是每位计算机研究者的核心能力
本讲目标
回答三个问题
是什么 what
为什么 why
怎么样 how
课程大纲
作业
课外阅读:算法导论 4ed 前两章
习题:1.2-2、1.2-3、2.1-3、2.1-4